Приручаем 2 миллиона строк хаоса…
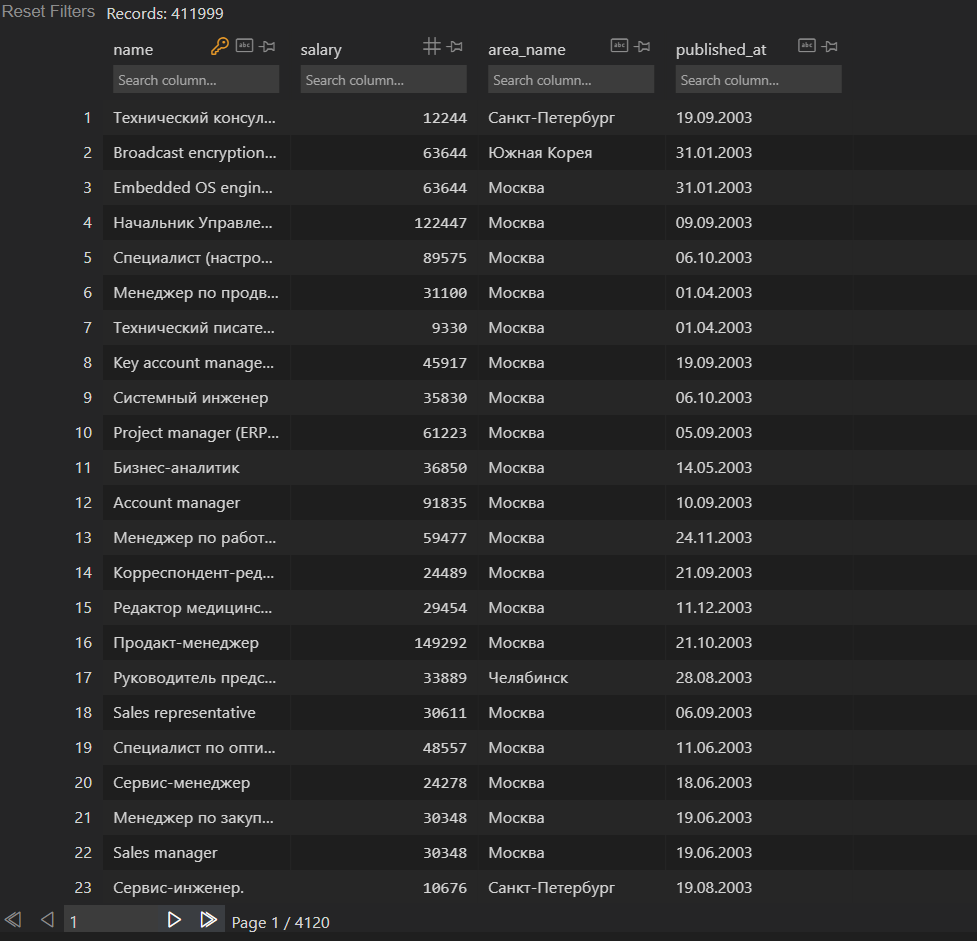
Представьте неподъемный файл, куда годами без разбора скидывали вакансии со всего мира: с опечатками, разной валютой, обрывками HTML-тегов и кривыми датами. Открыть такой файл в Excel — он просто зависнет.
Моей задачей было превратить эту гору сырых данных в быстрый веб-портал. Я разработала скрипты фильтрации: отсеяла пустые и некорректные записи, привела валюты к единому курсу и сохранила 411 999 идеальных строк в базу данных. Вся эта магия работает под капотом, а пользователь просто открывает сайт и за секунду видит понятную аналитику.
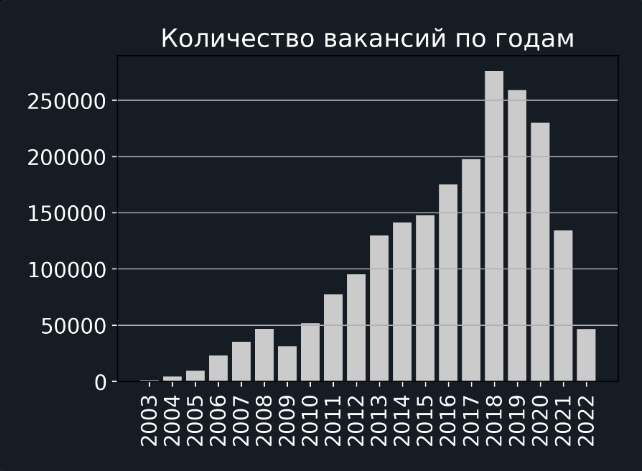
Сырых записей рынка труда проанализировано скриптом
Как же не повесить сервер на 2M записей?
Разделяй и властвуй!
Обычный скрипт захлебнулся бы в оперативной памяти. Чтобы сервер не падал, я разделила гигантский массив на годовые срезы и запустила их параллельную обработку.
def asynchronousProcessing(self):
"""Параллельная обработка годовых срезов данных"""
    files = os.listdir(path='./years-csv')

  # Раскладываем массив на независимые потоки по числу ядер — CPU загружен на 100%, память свободна

    with pool.ThreadPoolExecutor(max_workers=len(files)) as p:
        p.map(self.parserCSVByYear, files)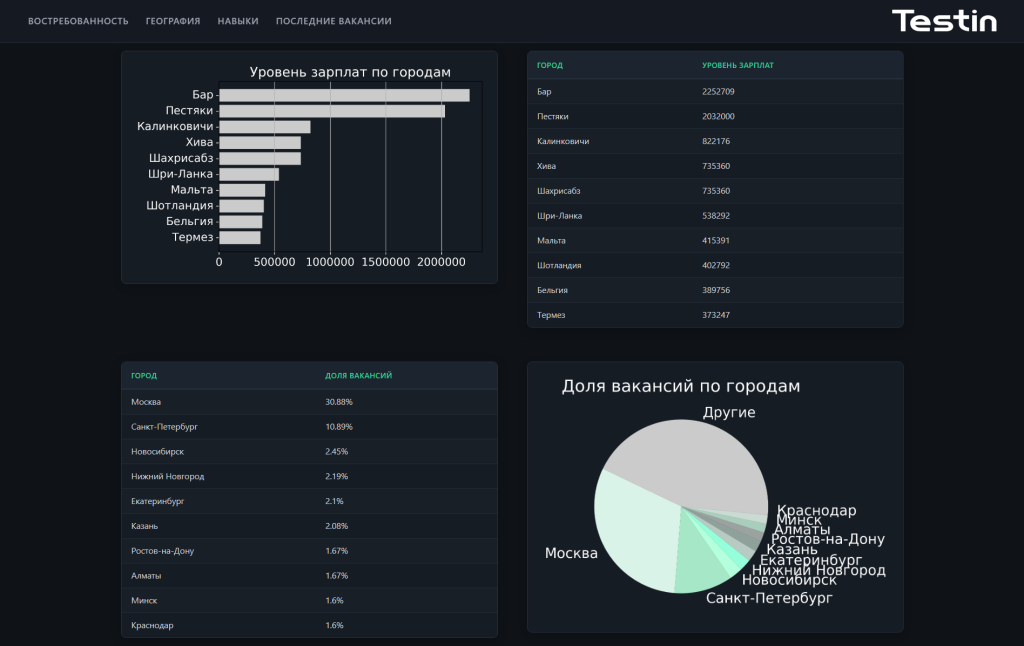
От сухих цифр — к наглядной аналитике
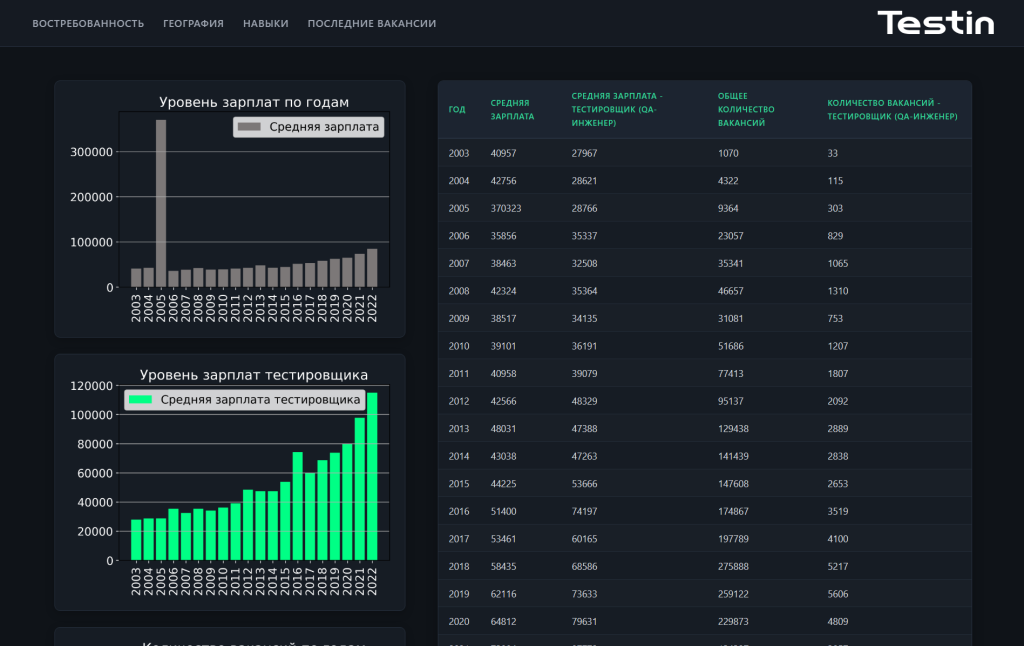
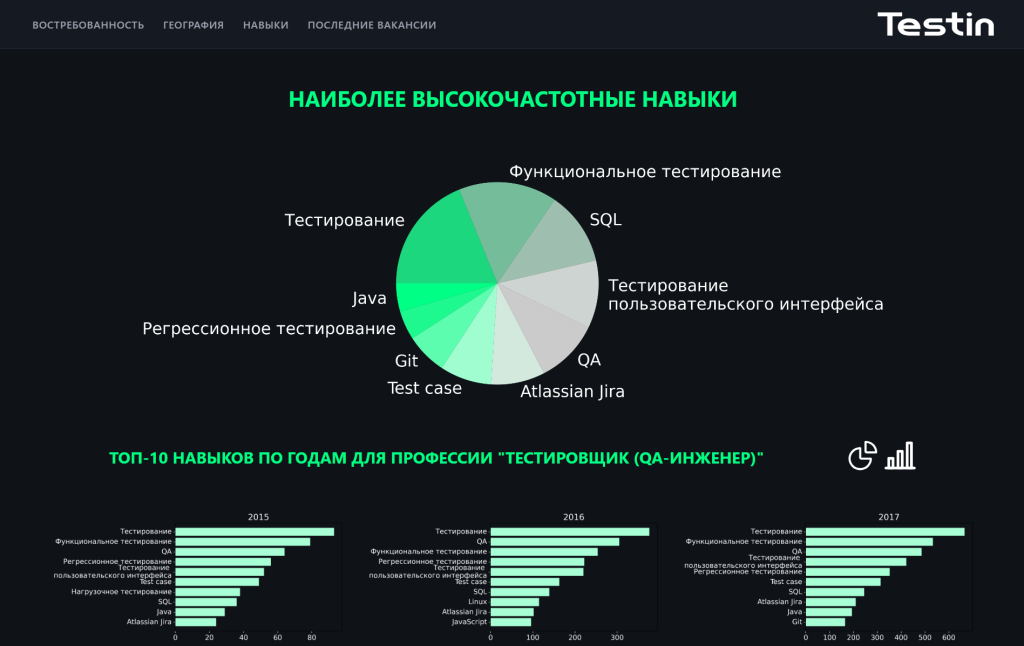
Пользователь не копается в таблицах — он выбирает специальность (например, QA-инженер) и сразу получает живую сводку: реальные зарплатные вилки, динамику спроса по городам и ключевые навыки.
Function over form
Строгий интерфейс с фокусом на плотность данных и мгновенную отрисовку таблиц. Система даже умеет собирать эти данные в готовый PDF-отчет и Excel для руководства или HR!
Under the Hood
А какие архитектурные принципы обеспечивают стабильность и скорость работы сервиса?
Параллельная работа
Чтобы скрипт не обрабатывал 400k строк полдня, я запустила обработку в несколько потоков. Время ожидания сократилось в три раза.
Автоматические тесты
Сложные части расчетов (перевод валют и округление зарплат) я покрыла тестами. Если курс меняется — ничего не ломается.
Умный кэш
Когда внешние сайты и API меняют правила или падают, сервис продолжает летать, потому что опирается на свою оптимизированную базу.
Выделение профессии (QA)
Из общего массива в 2.1М строк алгоритм автоматически вычленяет только релевантные вакансии тестировщиков по синонимам и матрице грейдов.
Так грамотная работа с потоками и алгоритмами позволяет обрабатывать миллионы записей даже на скромном железе без раздувания бюджета на серверы. От хаоса в таблицах до живой аналитики — за один пайплайн.
Большие данные — не всегда большие расходы
*Архивный проект (Data Processing pipeline). Полный исходный код и инструкция по запуску — в репозитории.